
AI First、中文优先的自托管学习系统:资料、卡片、主题与间隔重复住在同一个纸感工作区里——对内有常驻 Agent 替你切卡、出题、维护知识地图,对外提供 skill,让 Claude、Codex 等其他 Agent 直接投喂同一份数据。你负责扔进去,消化和复习仍在 Inwit。演示站点 inwit.aimo.plus/topics,源码在 GitHub。
产品理念
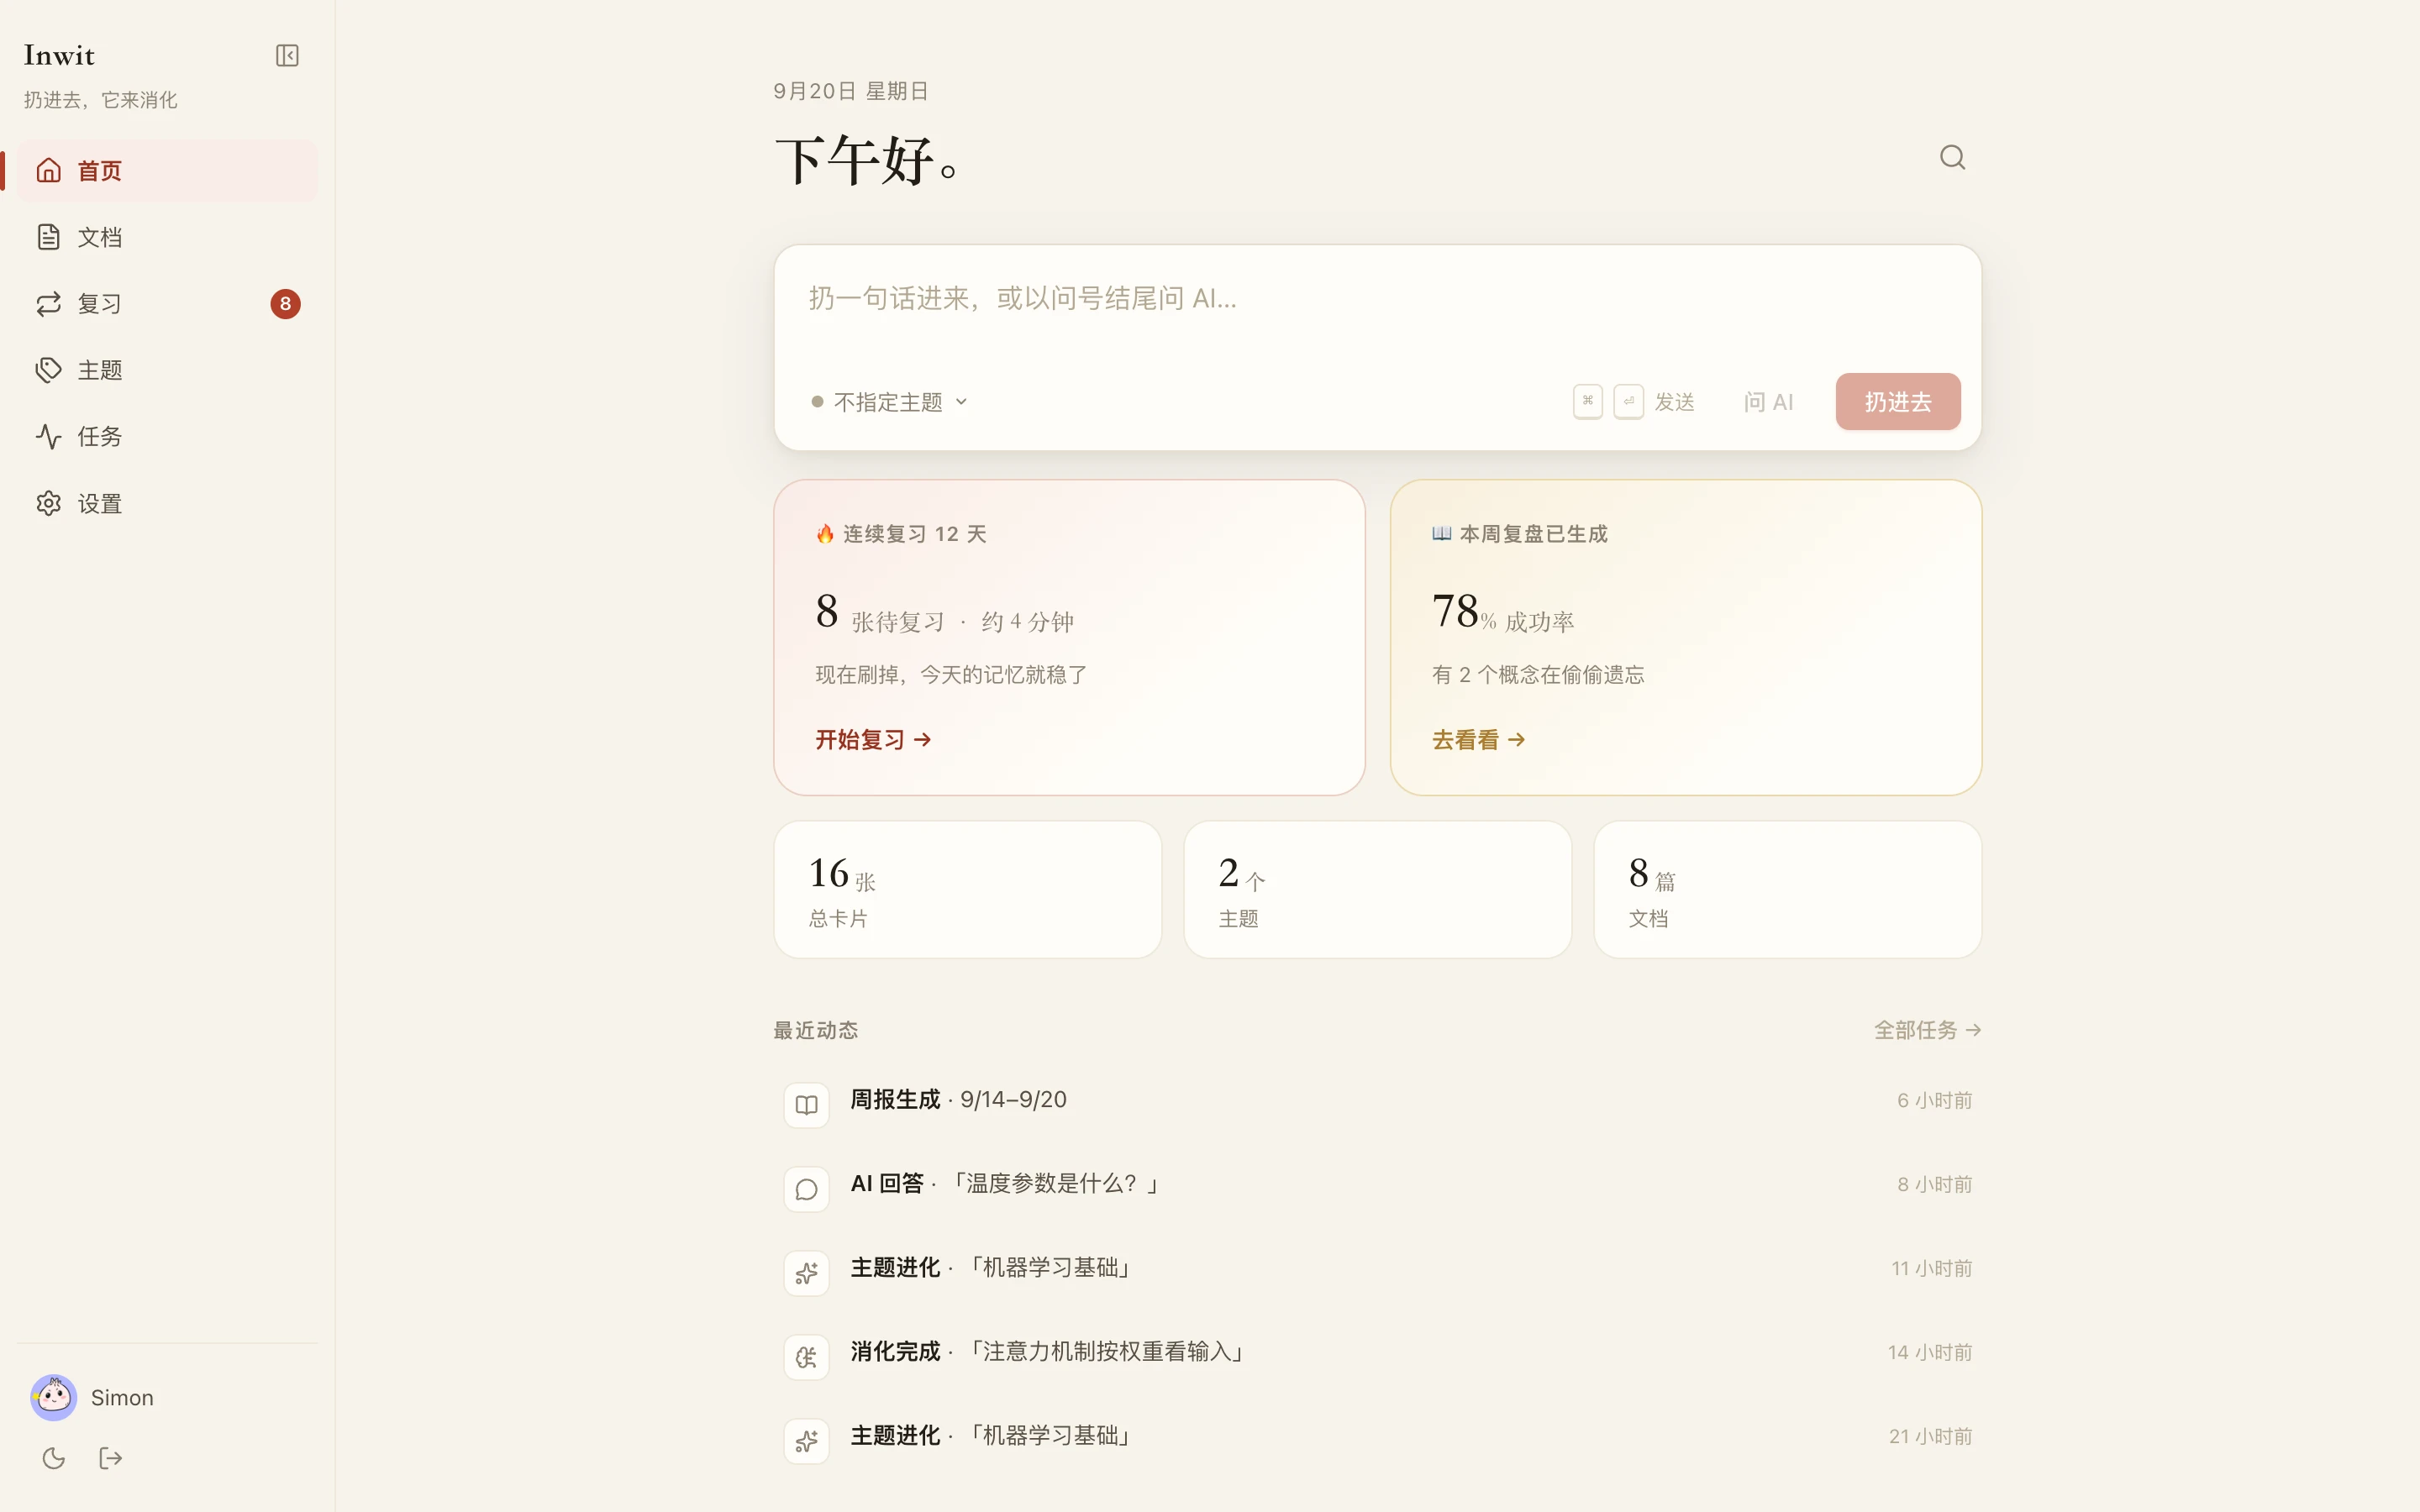
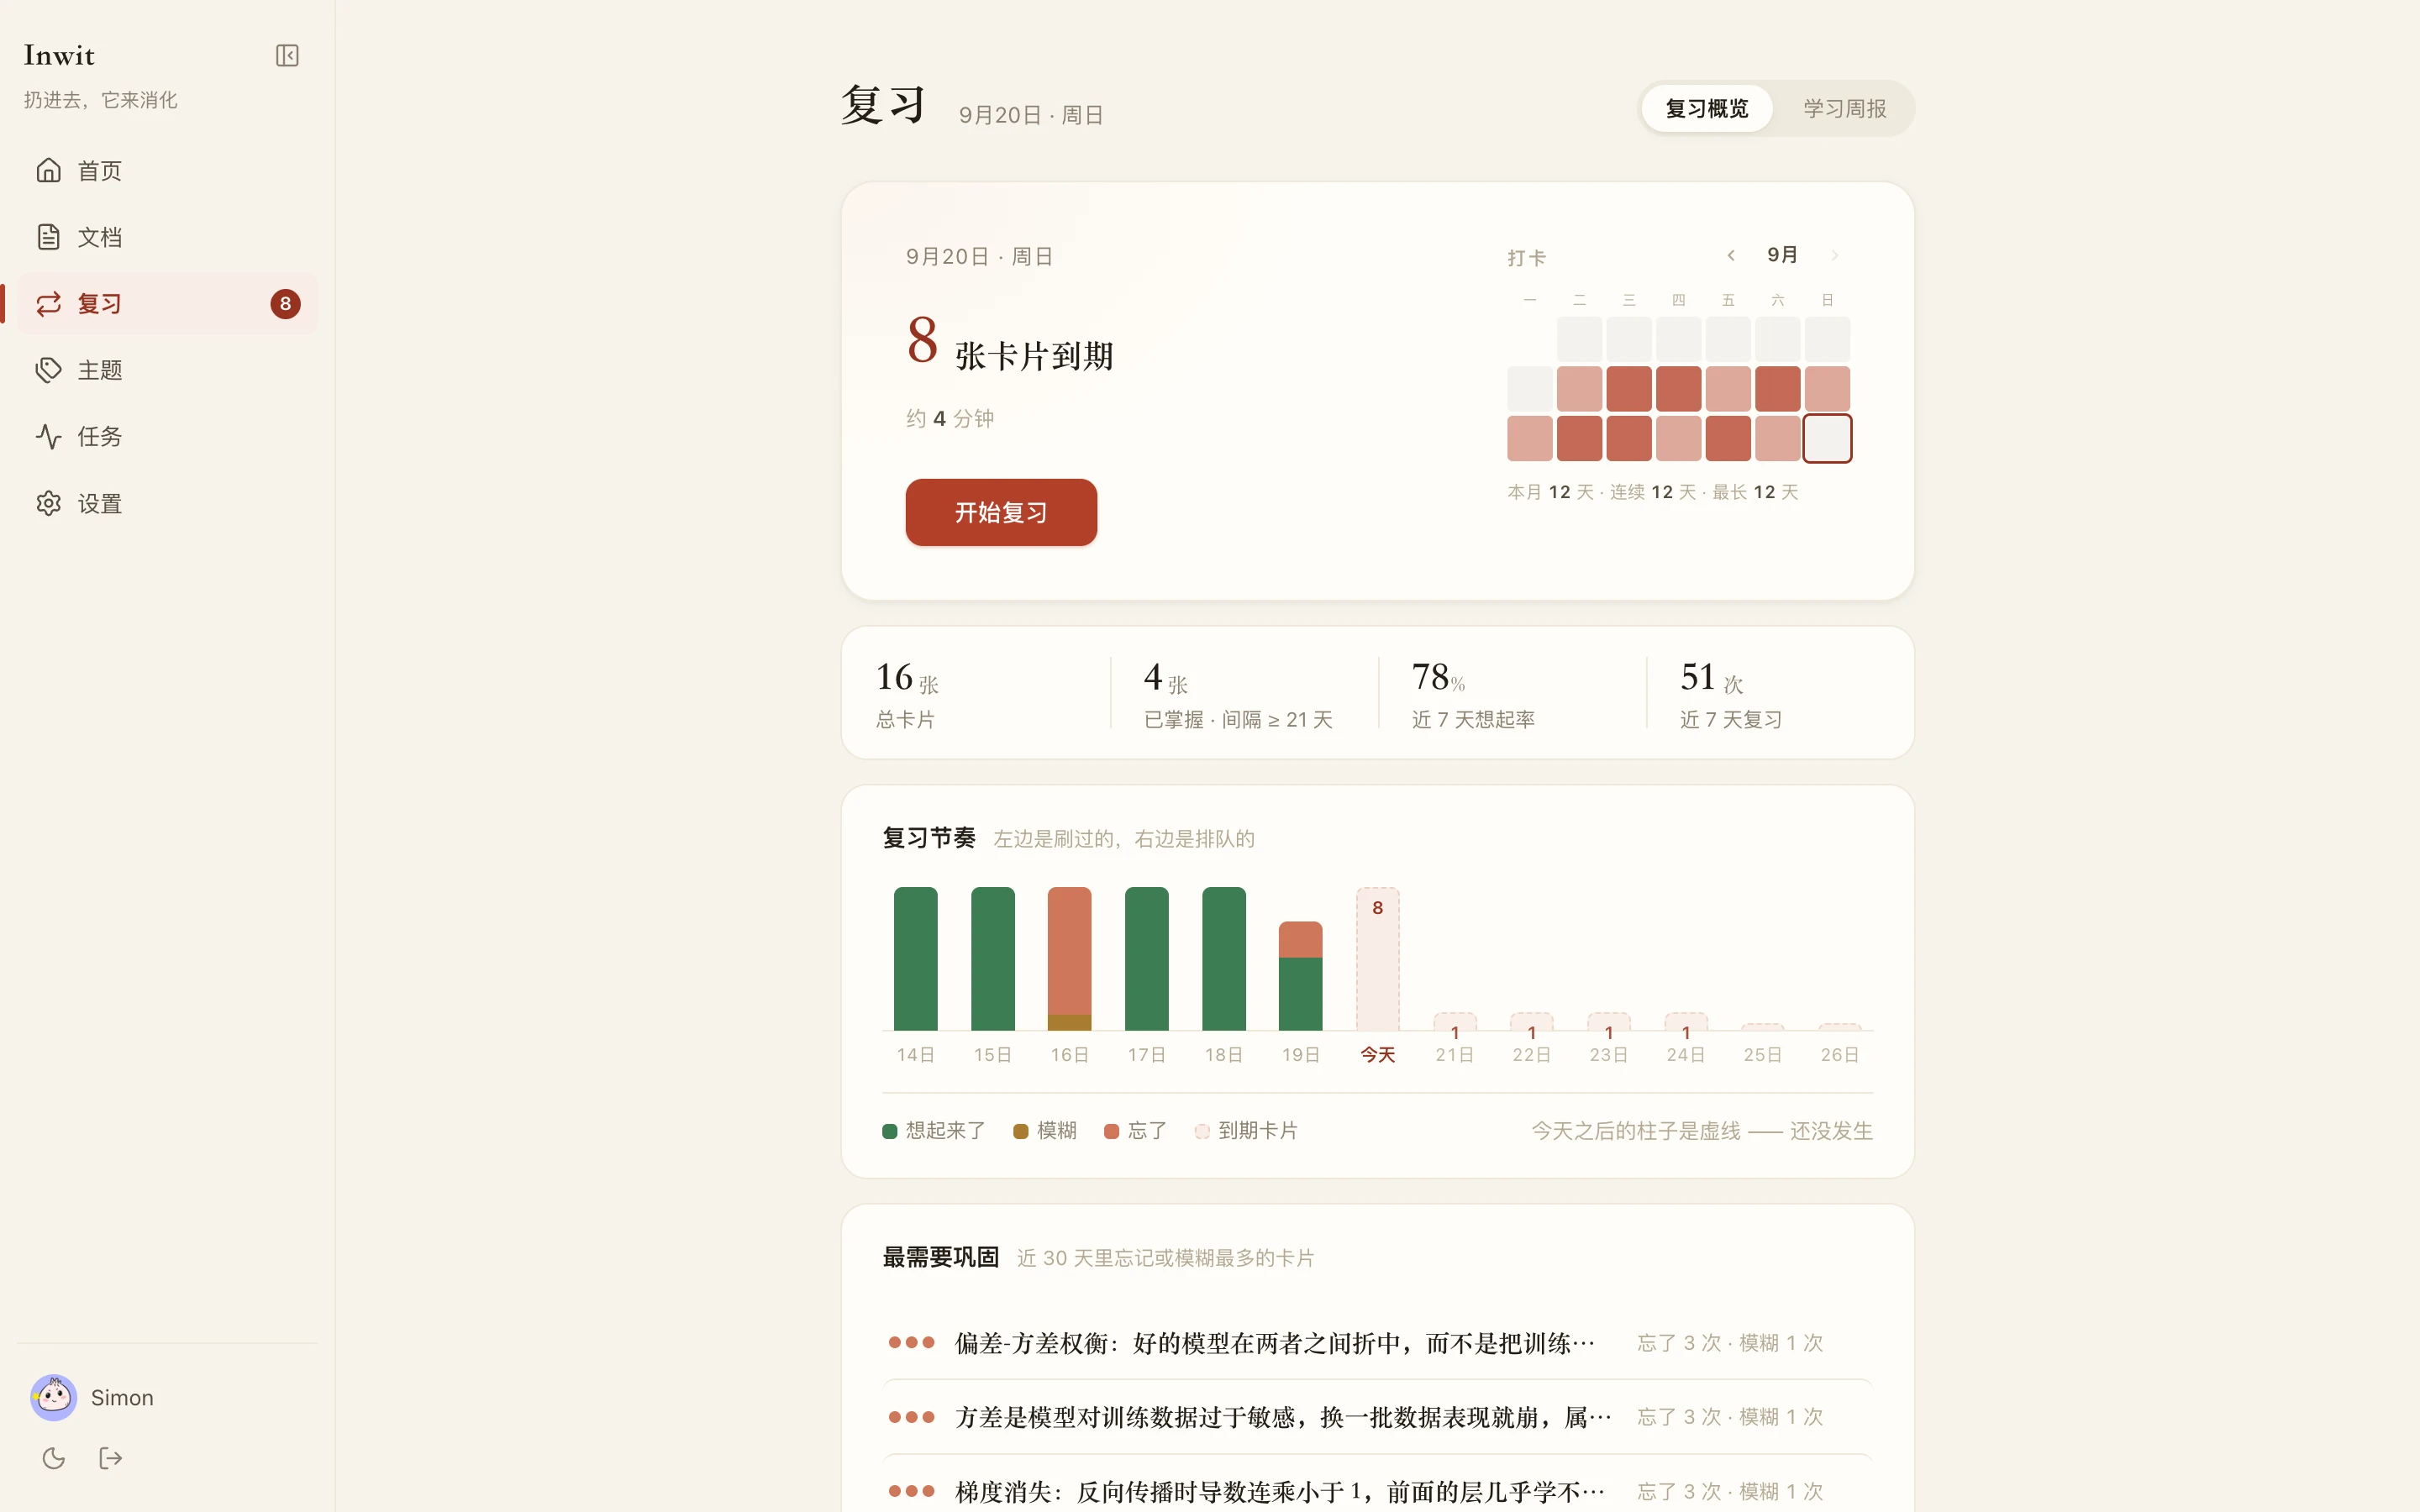
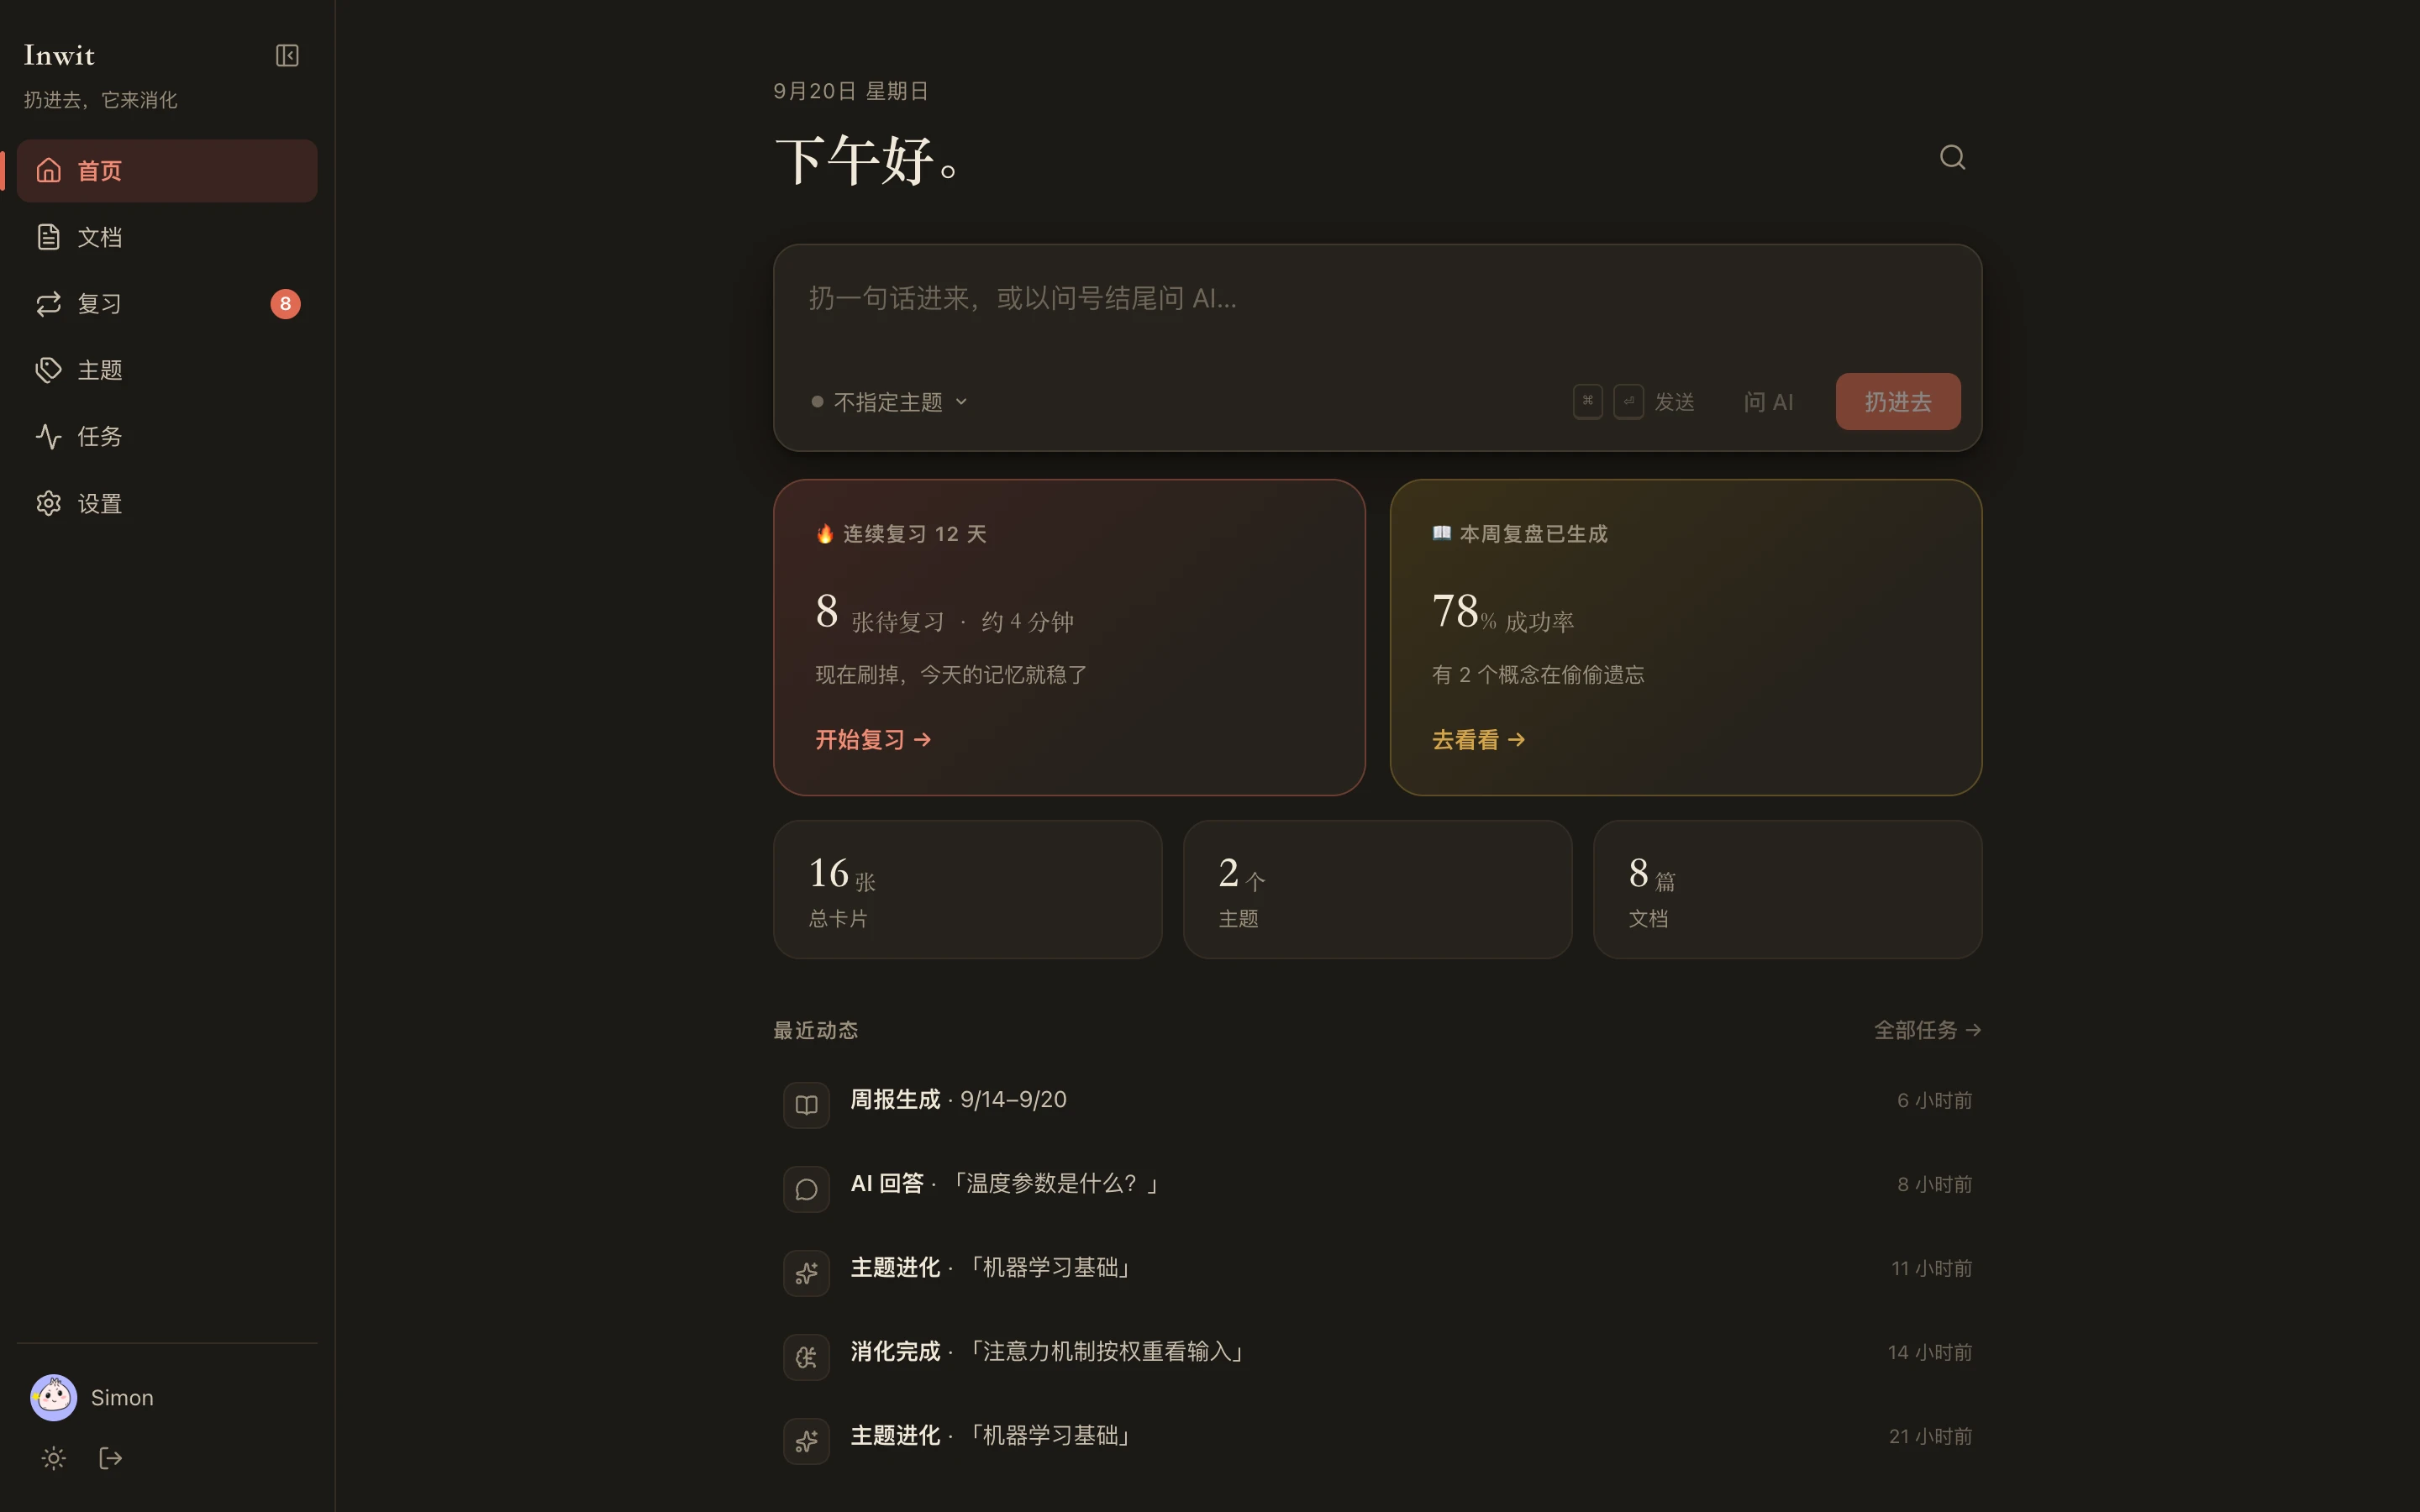
Inwit 是 AI First,同时追求 纸上学习:打开后先看到今天该回忆什么,而不是文件夹和标签;Agent 在后台切卡、出题、画地图,提议开题要你点头才落地。
学习收成四个动作:输入 → 消化 → 记住 → 贯通。
- 一个闭环,而不是一堆工具:笔记、问号、截图先丢进资料;消化 Agent 切成原子卡片并出题;复习按遗忘曲线推到今天的队列;三档反馈再驱动换讲法、拆卡和周报。编码 Agent 也可以当投喂口,但不另起一套笔记。
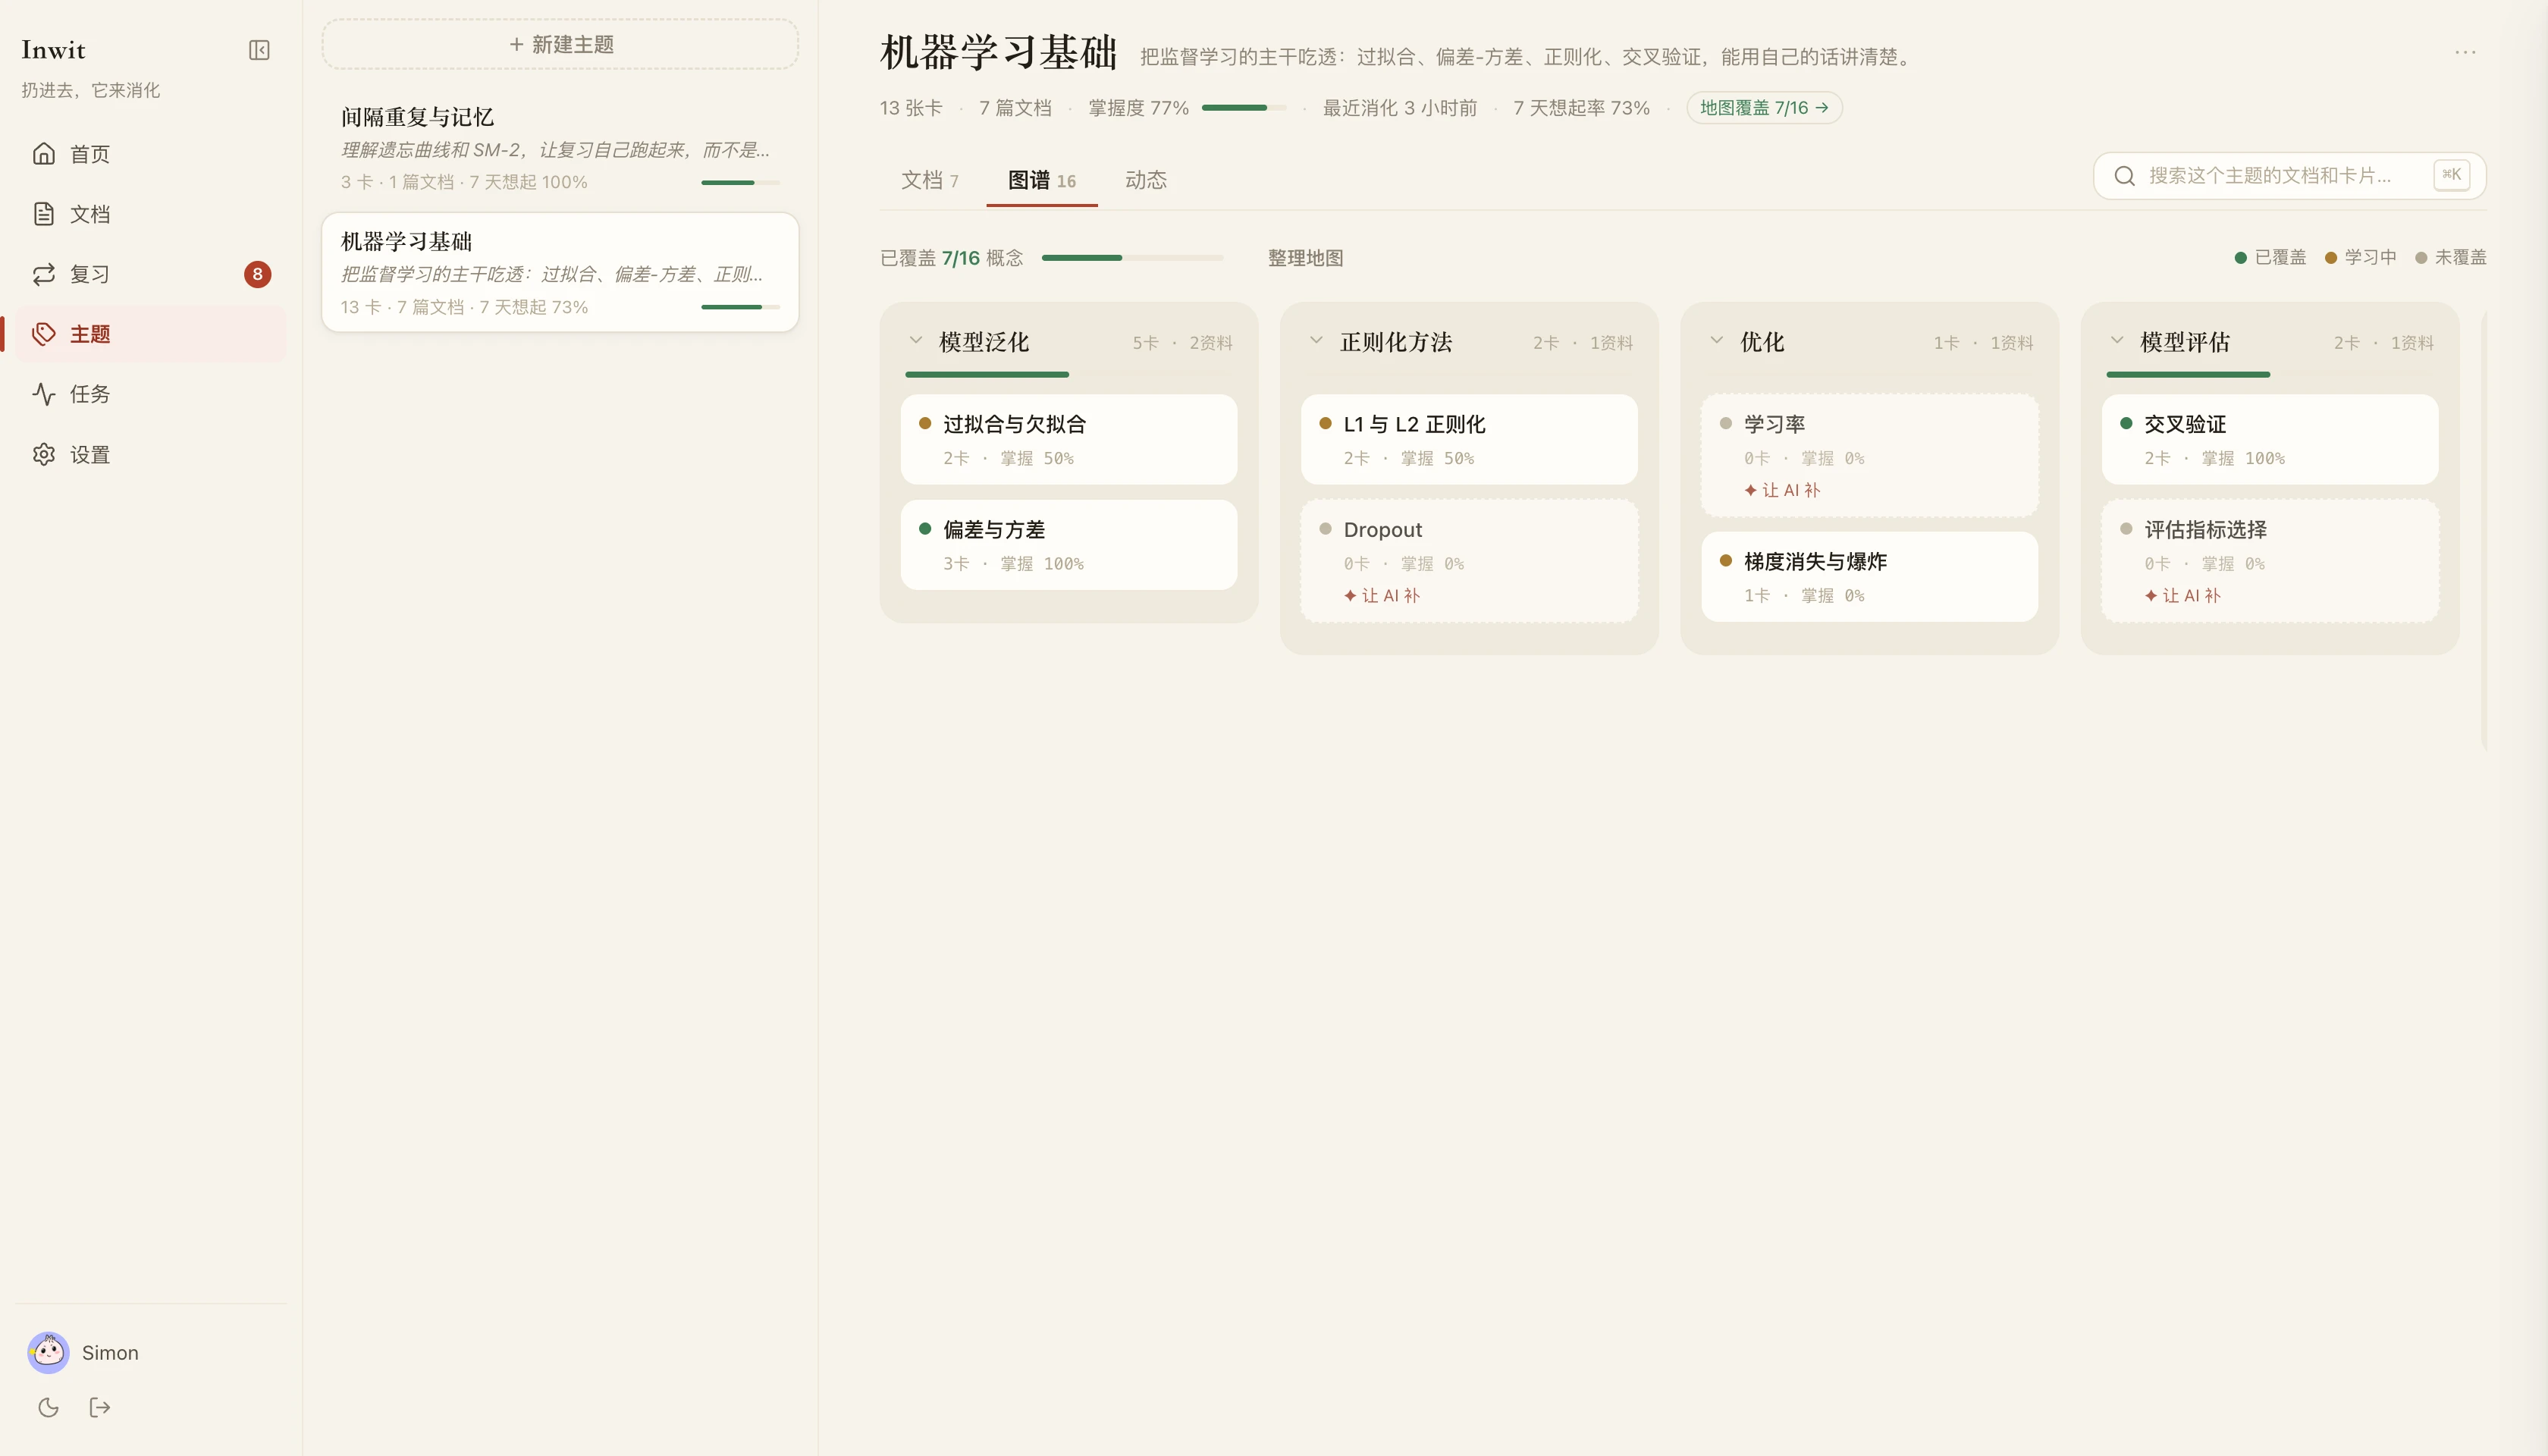
- 你只做输入:不要求分类、打标签、选文件夹。主题不是文件夹,是 Agent 替你维护的知识地图;空白节点可以让 AI 补一张入门卡。
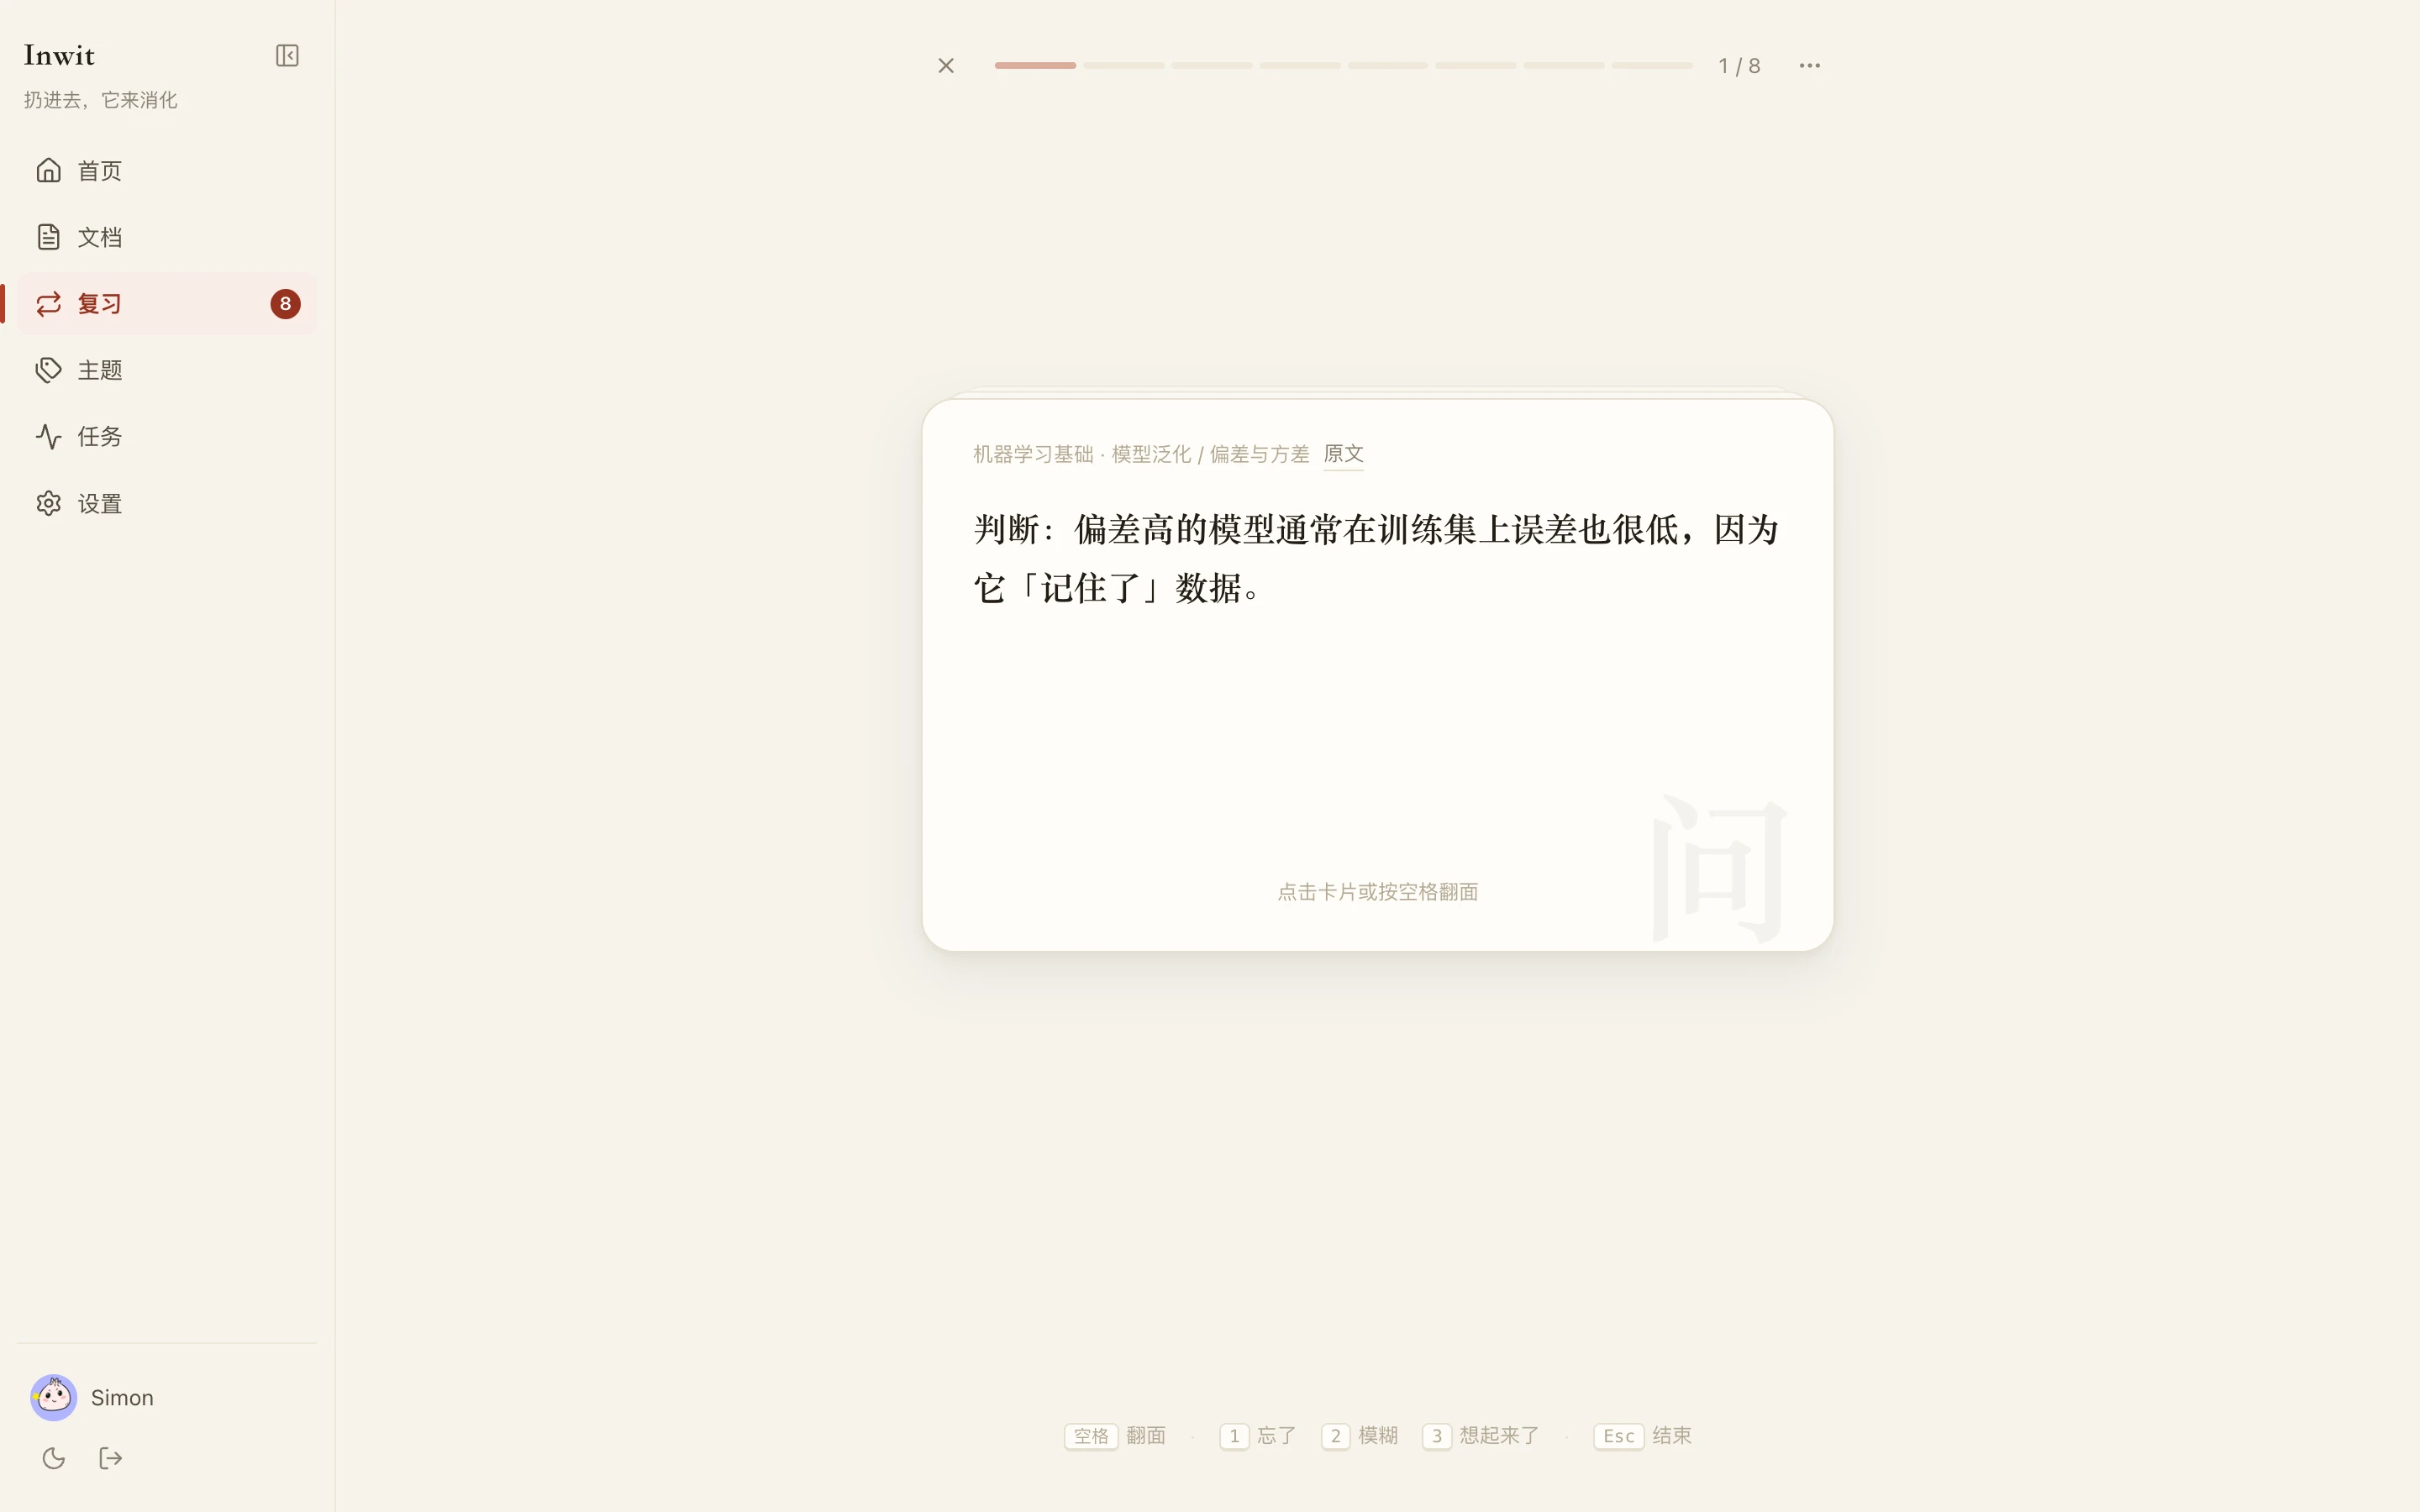
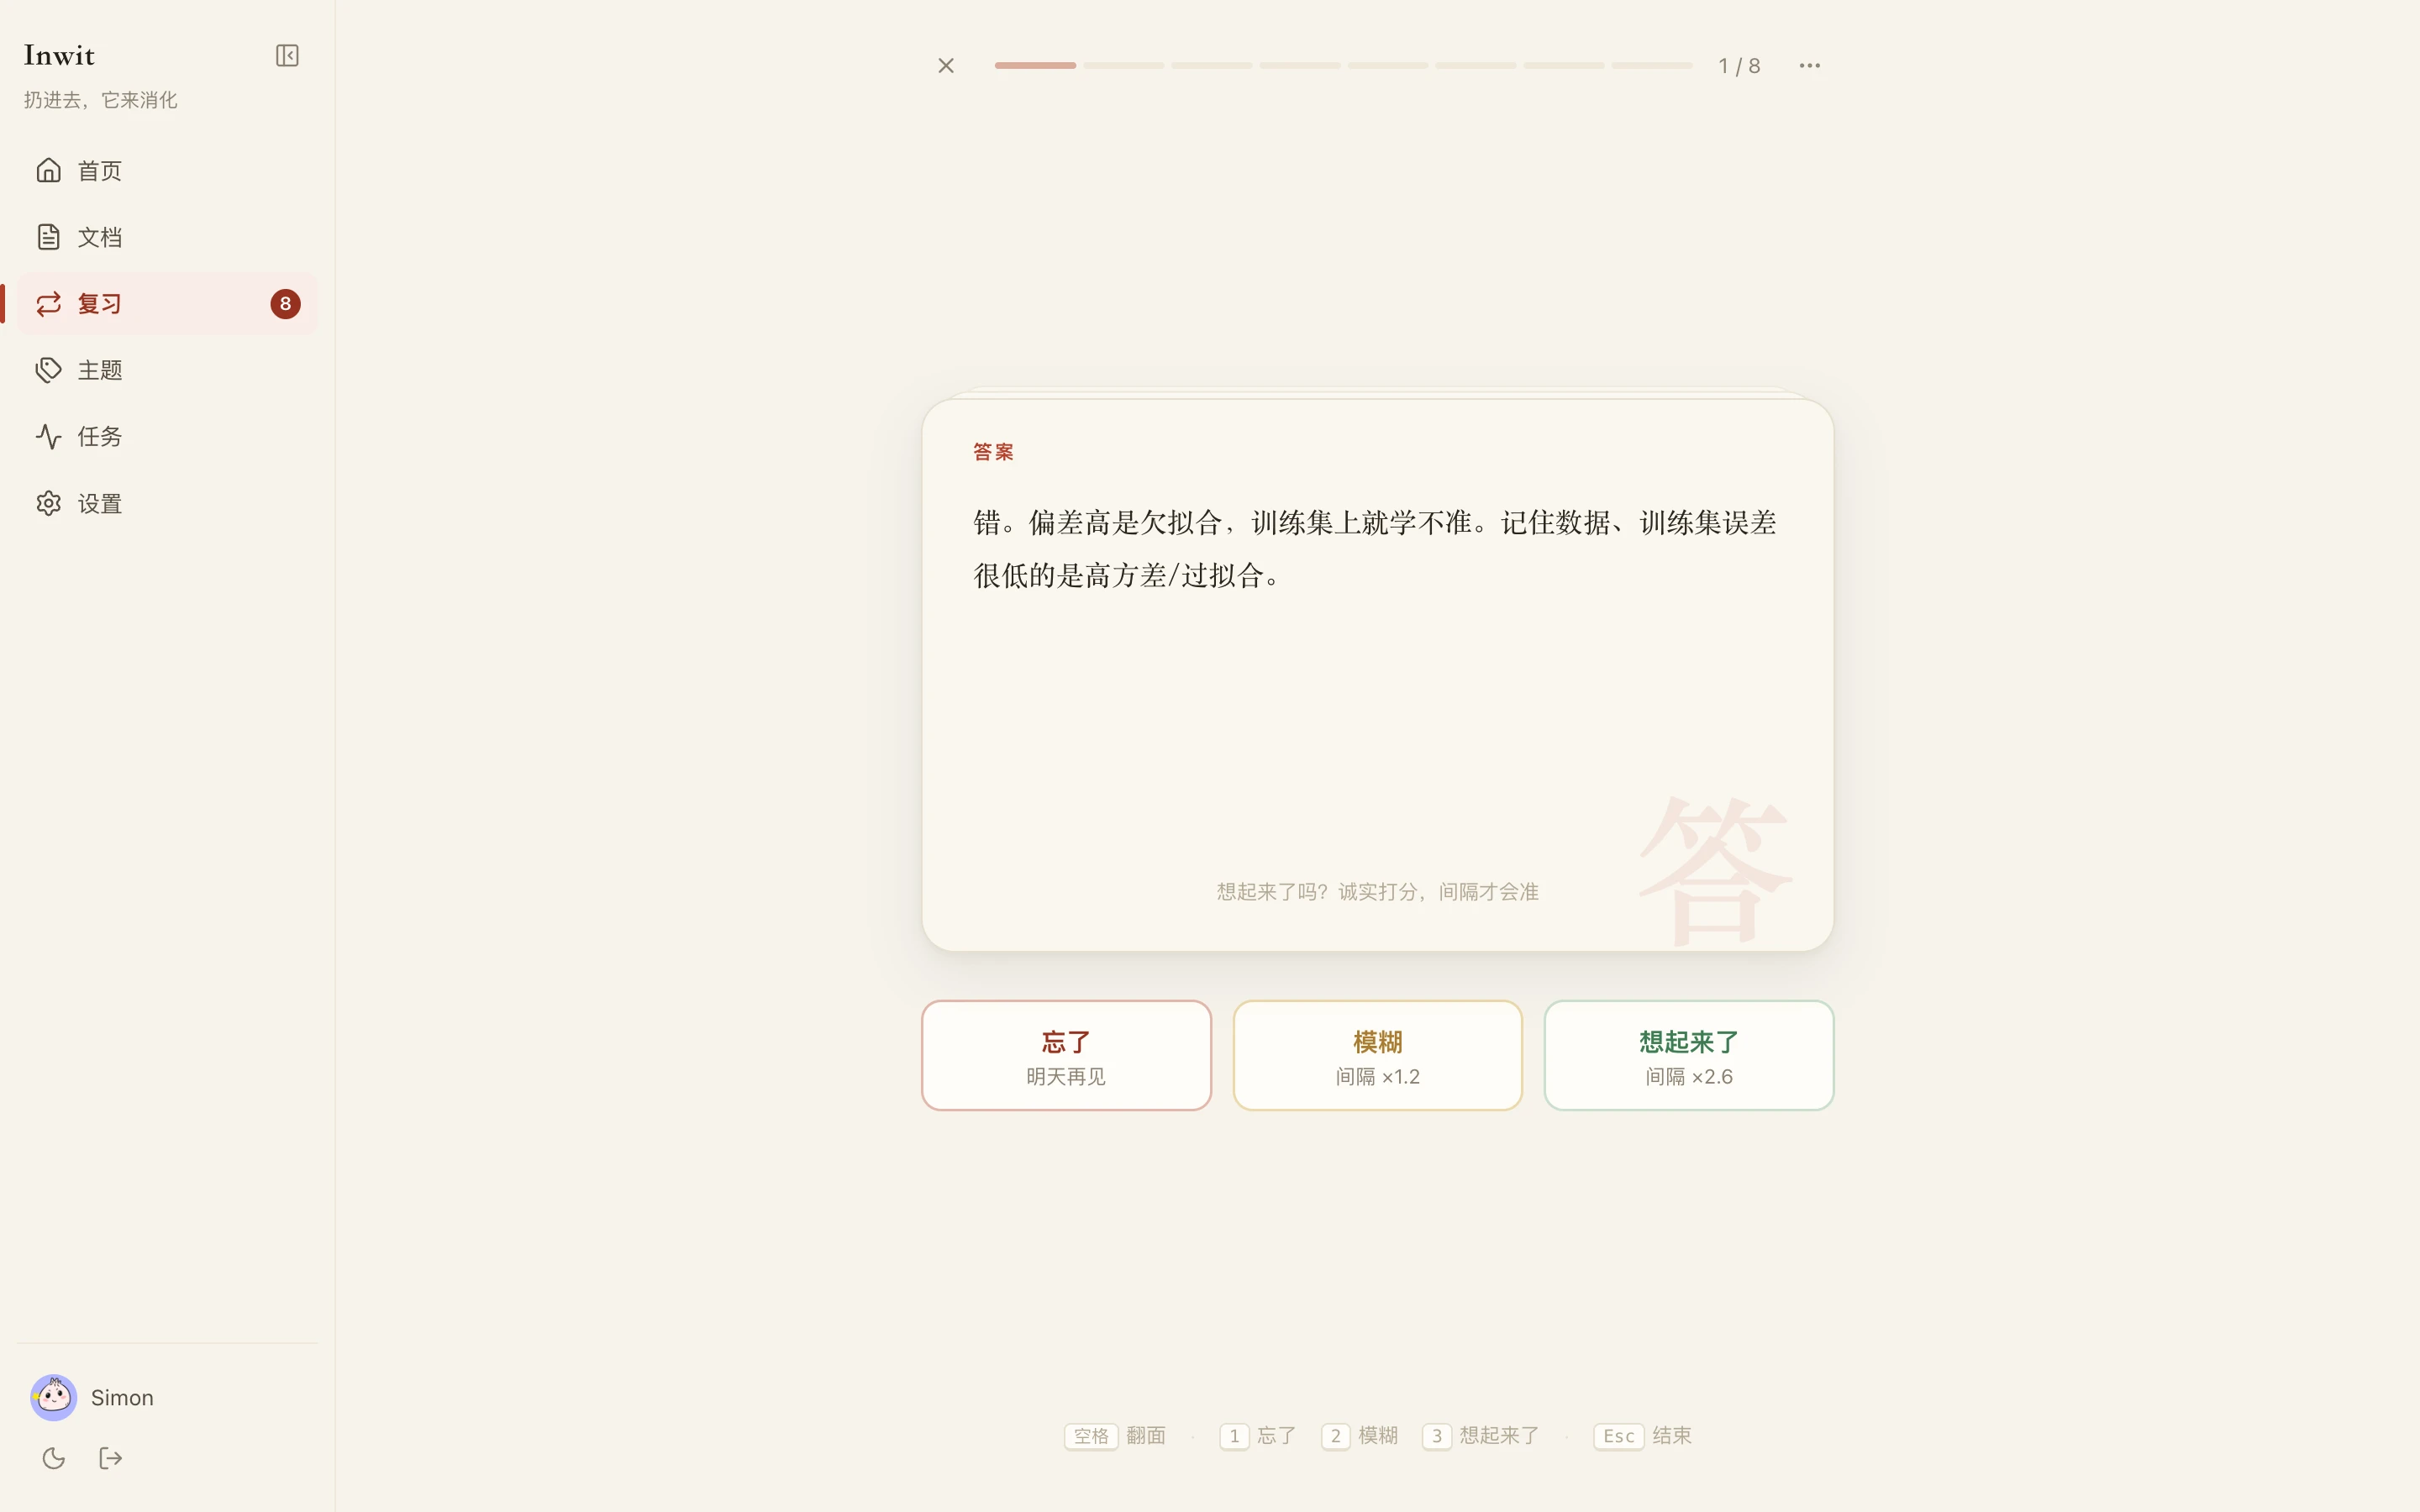
- 回忆必须是你自己的:切卡和出题可以交给模型;翻面之前先想,三档反馈才写进 SM-2。偷看作对,下次只会隔得更远。
- 基础层不依赖 AI:卡片 + 间隔重复在没有模型时也能跑。AI 只做增强:换讲法、拆小、对比专题、周报。密钥按需配置(BYOK),用量在任务页可见。
视觉主题为 纸上学习:宣纸底、暖墨字、朱批红。浅色是白日书桌,深色是灯下夜读。
Agent · AI First 的两条路径
Inwit 把 Agent 当成产品的一部分,而不是外挂聊天窗。
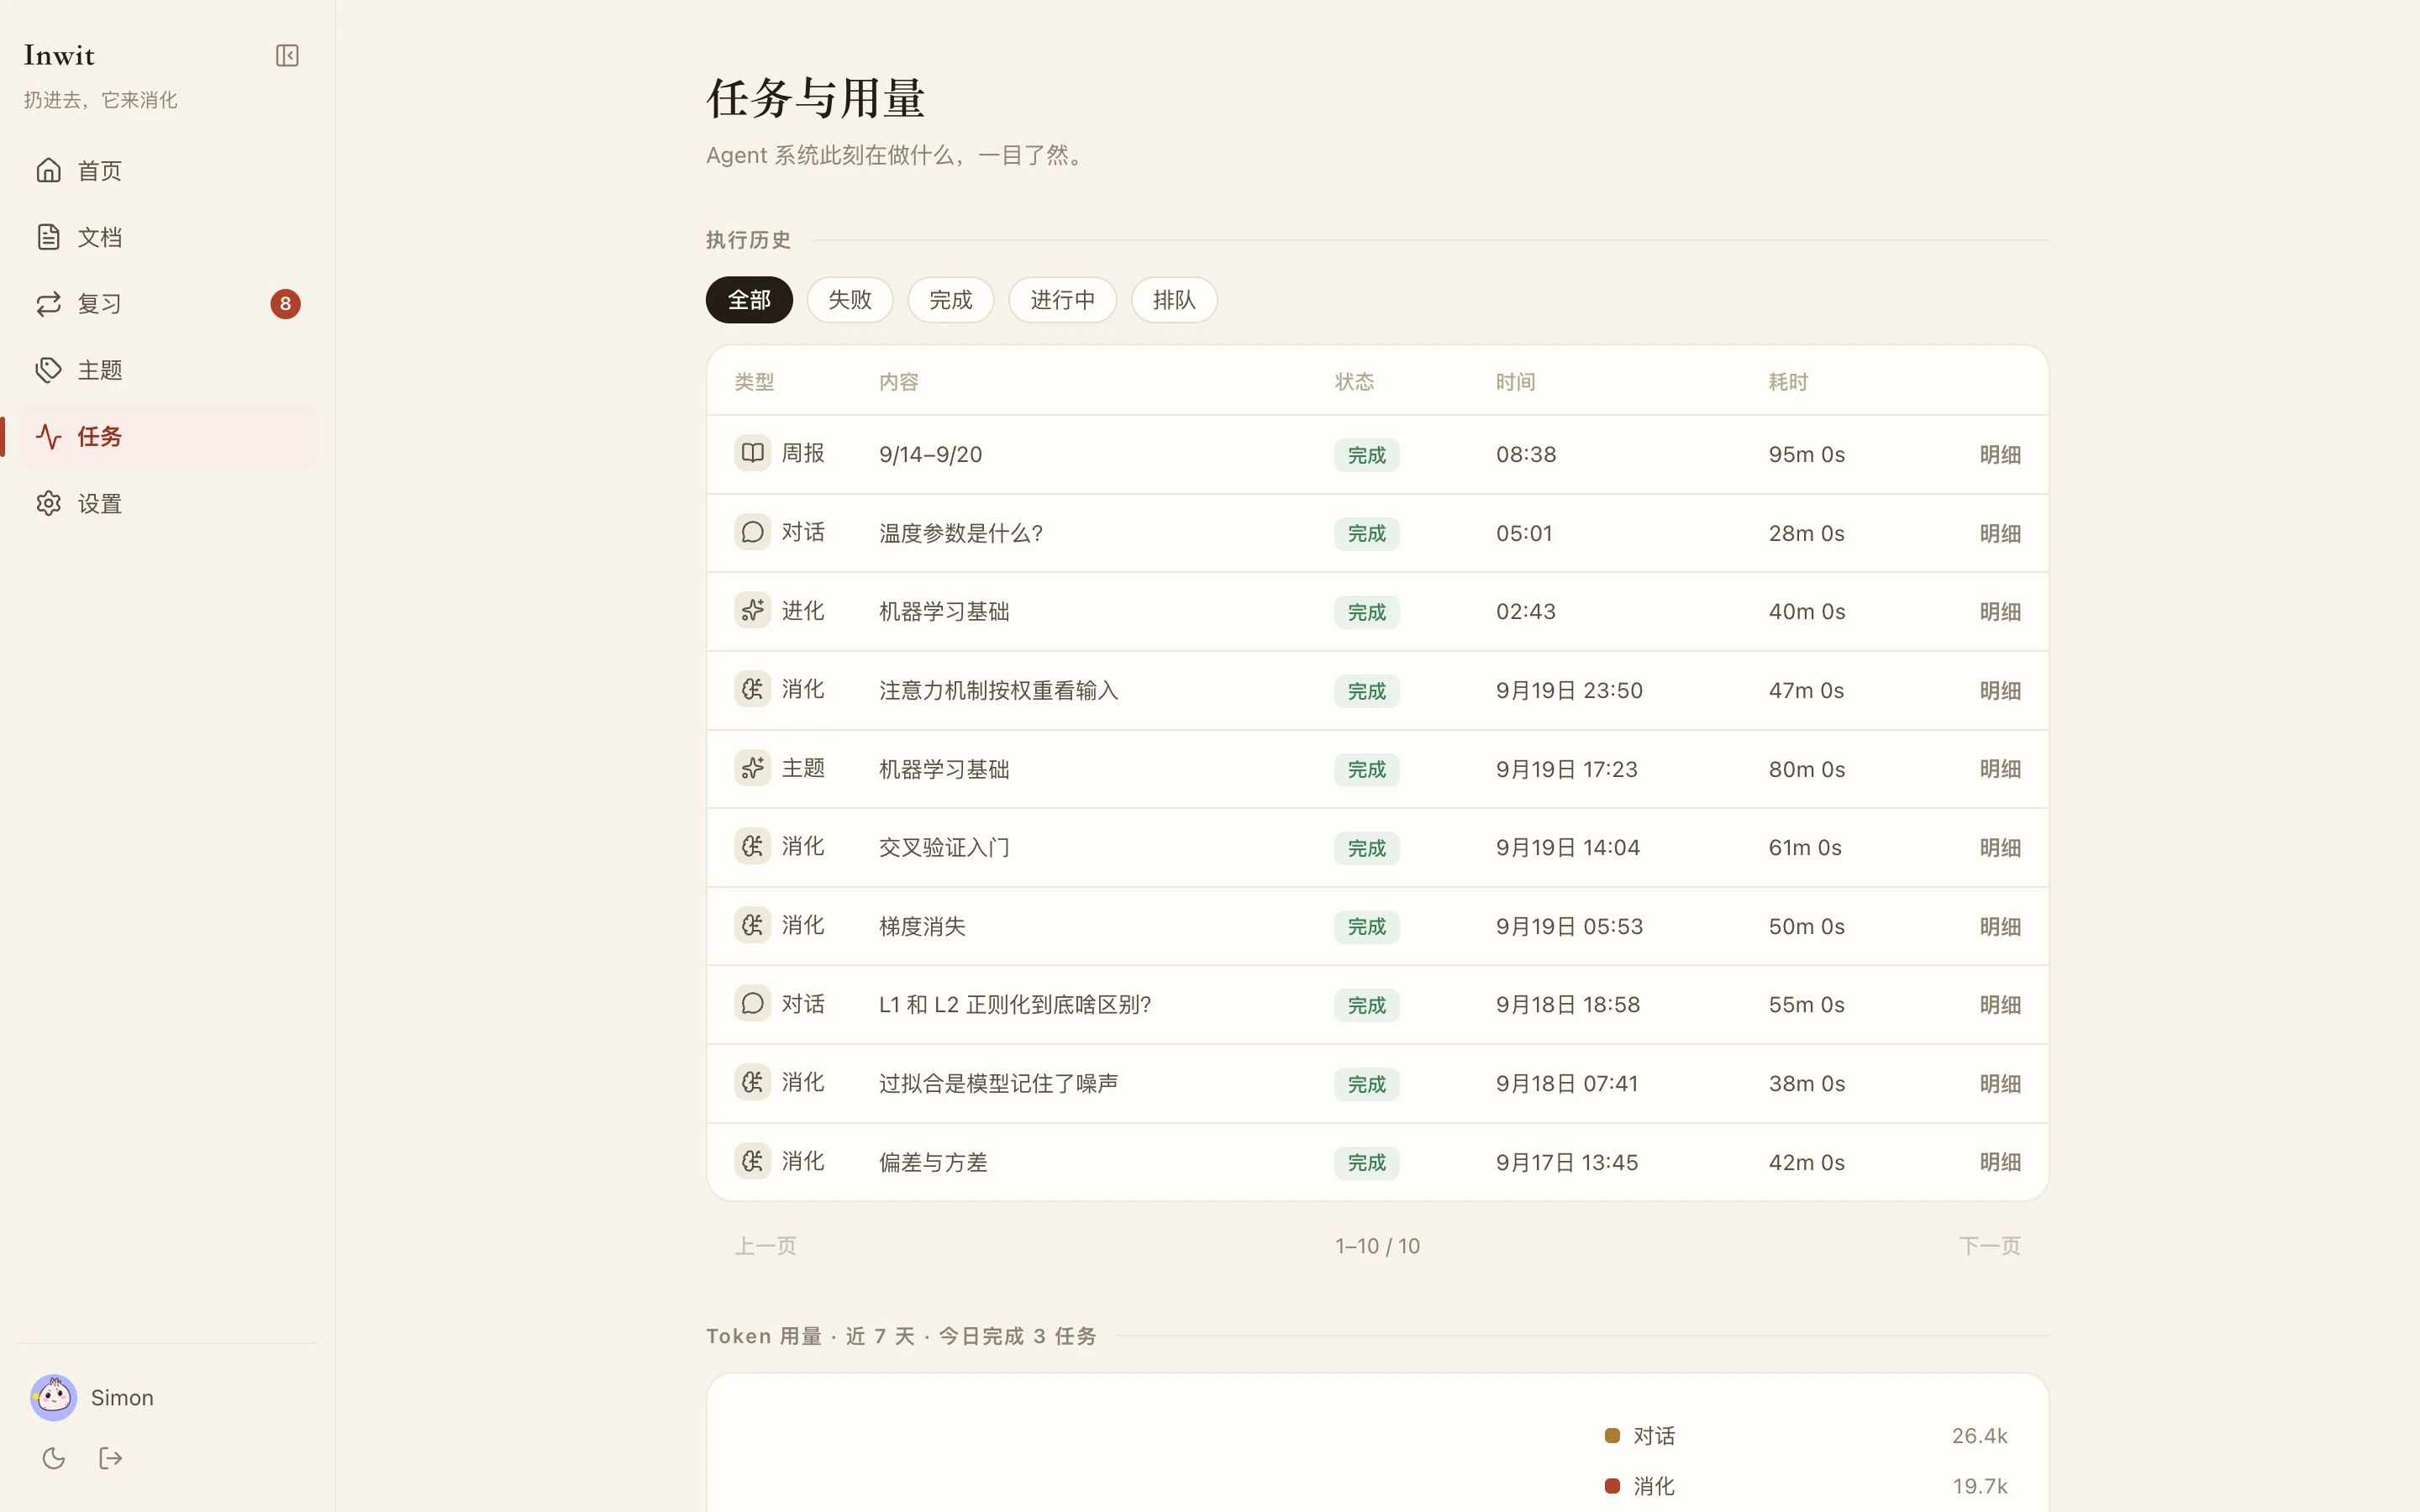
对内:独立 worker 轮询 jobs 表,消化资料、回答问题、整理地图、根据复习反馈进化,并按周写复盘。状态不在进程内存里:领取、超时回收、失败重试都落在 PostgreSQL,进程重启也能接着跑。切卡会直接写入,开题要你点头。三档反馈(忘了 / 模糊 / 想起来了)才改间隔。
对外:仓库自带可安装的 skill(skills/inwit/SKILL.md),Claude、Codex、Cursor 等任何能跑 skill 的 Agent 都可以用 iwt_ 个人访问令牌调用同一套 HTTP API——投喂笔记、提问制卡、看今日队列、读主题地图。对内 Agent 和对外 skill 操作的是同一份数据:你在网页里扔的,Claude 看得到;Claude 投喂的笔记,首页和文档列表立刻出现。
功能速览
资料:课件、草稿、剪藏、截图、AI 回答,全部是文档。文档工作台把阅读、编辑和卡片放在同一个窗格,Agent 切出的原子卡挂在原文锚点上。
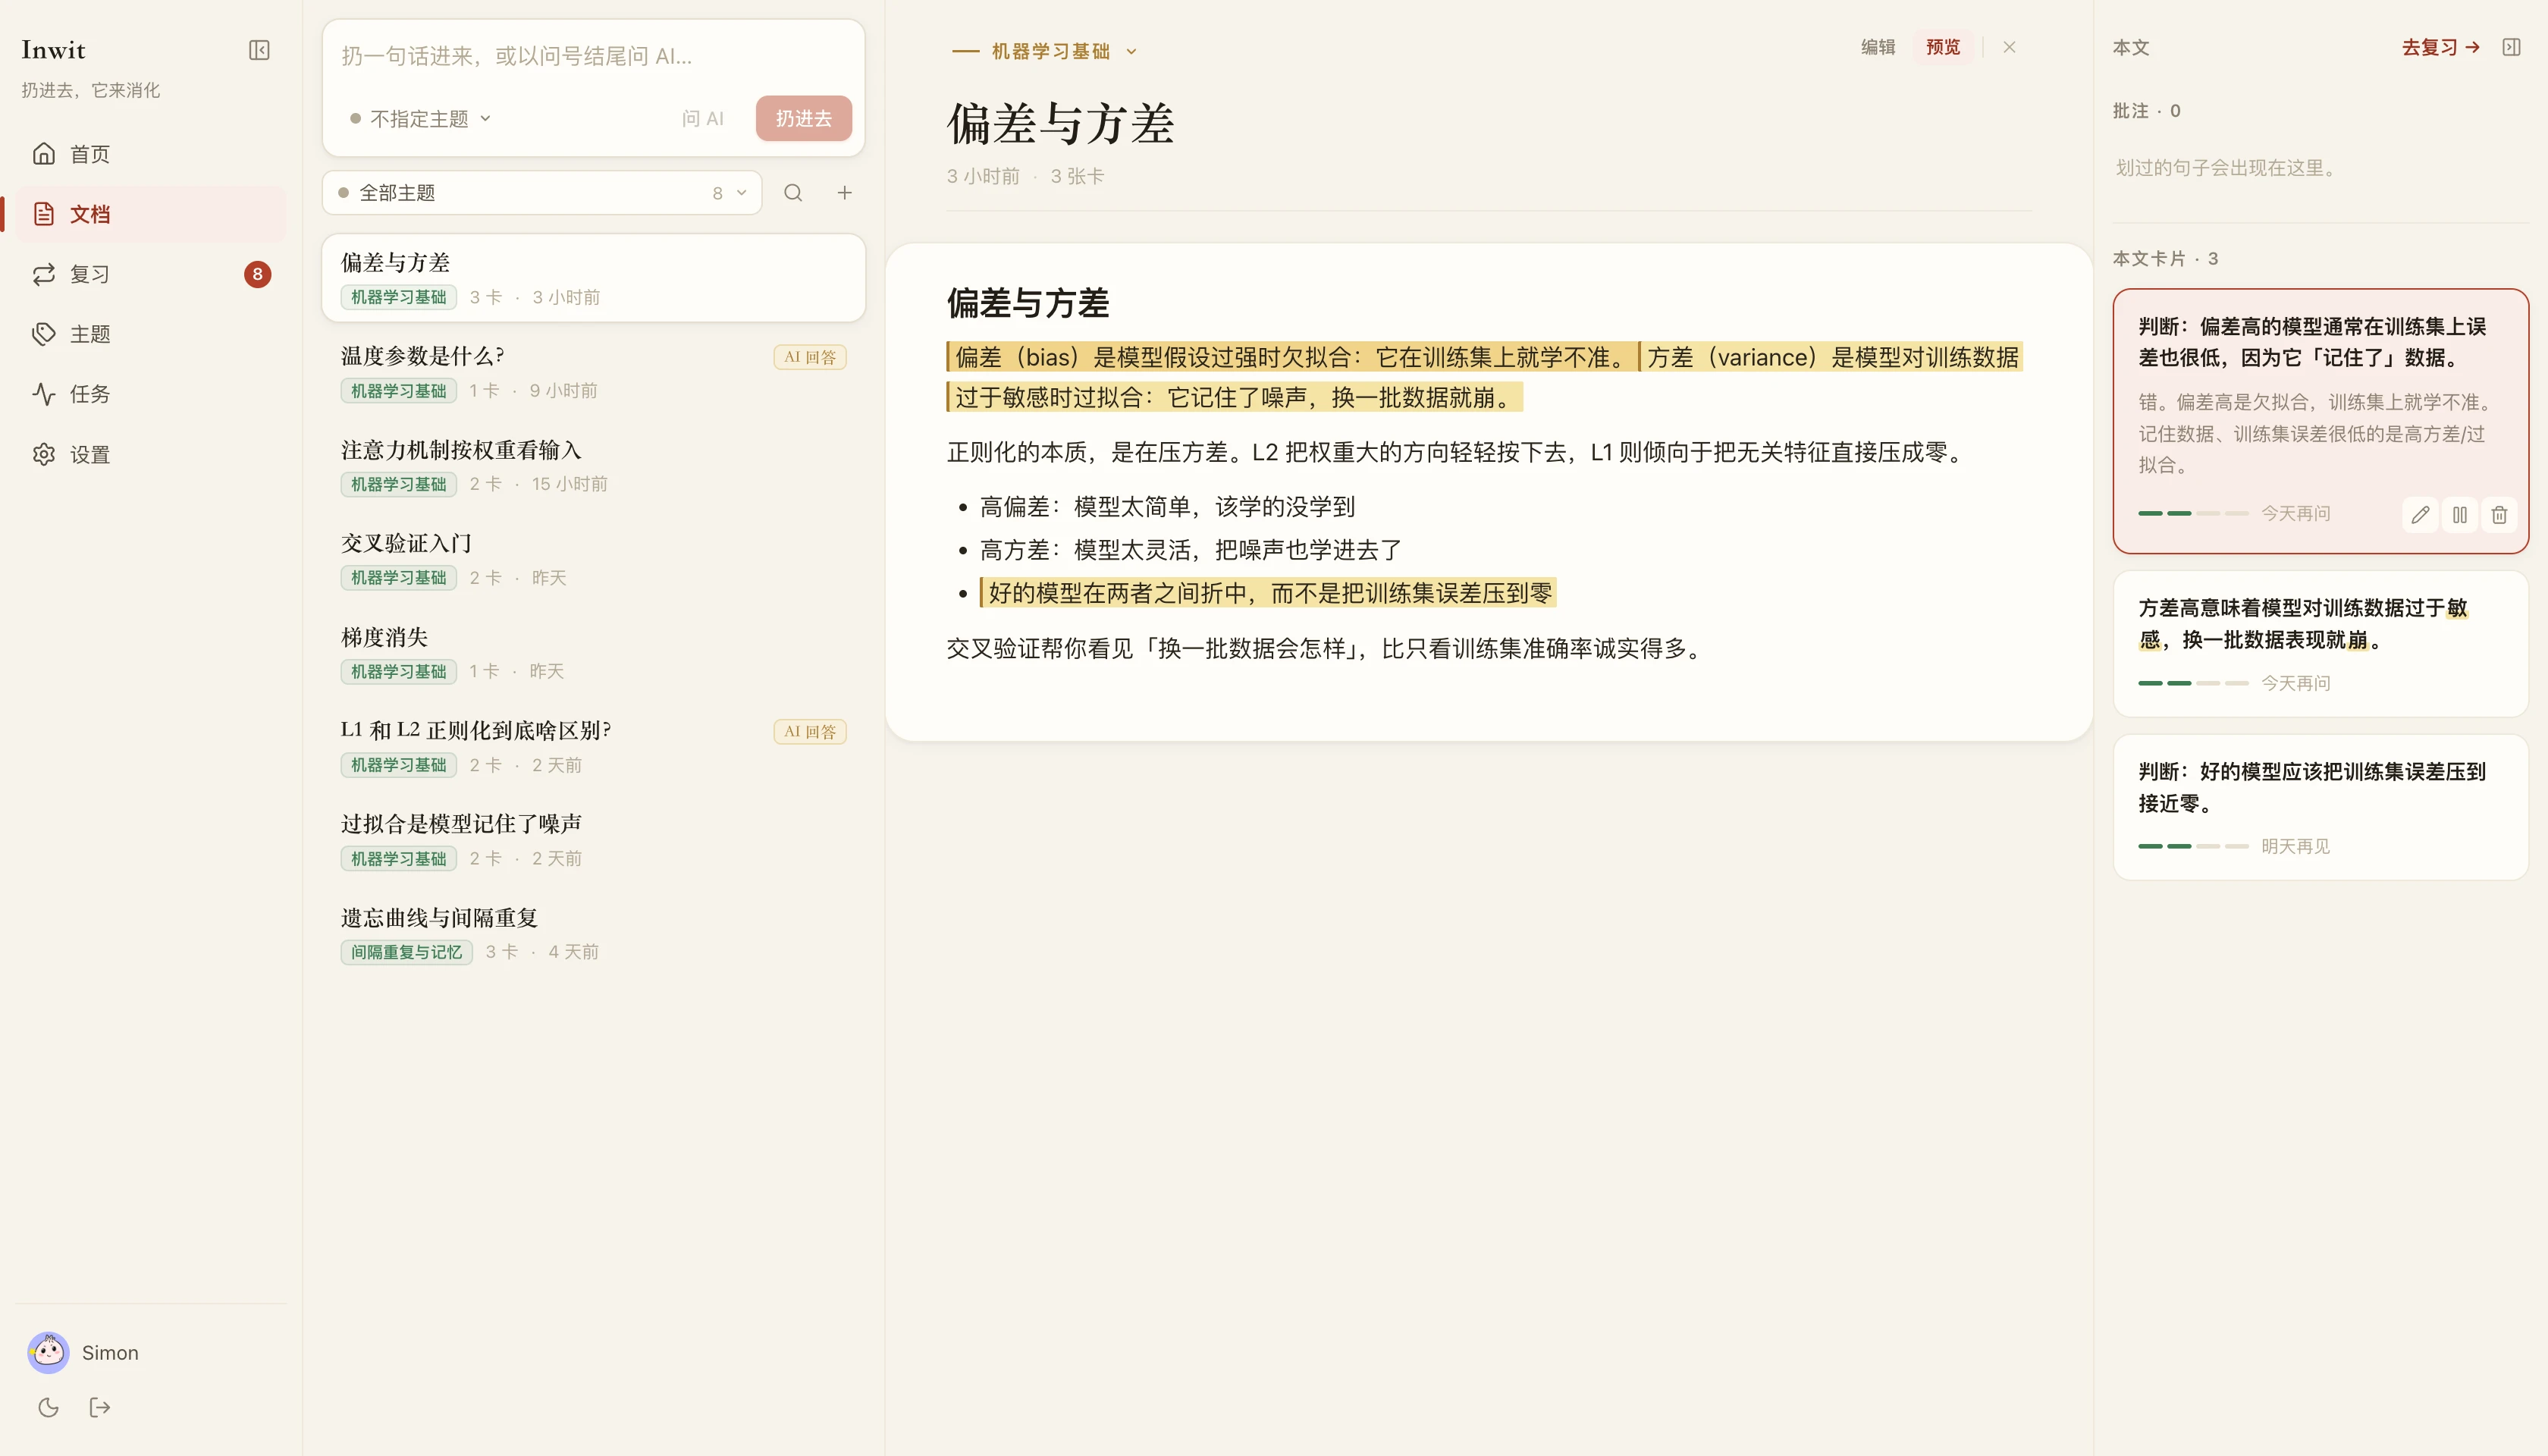
卡片:一条概念 + 一个例子 + 一个易混点,带出处锚点。复习按 SM-2 推到今天的队列;翻卡时先自己想,再翻面,三档反馈决定下次出现的时间。
主题:你给自己开的一门课,有目标、有资料、有卡片、有知识地图。地图由 Agent 维护:已覆盖、学习中、尚未碰到的概念一眼能看见;虚线节点可以让 AI 补。
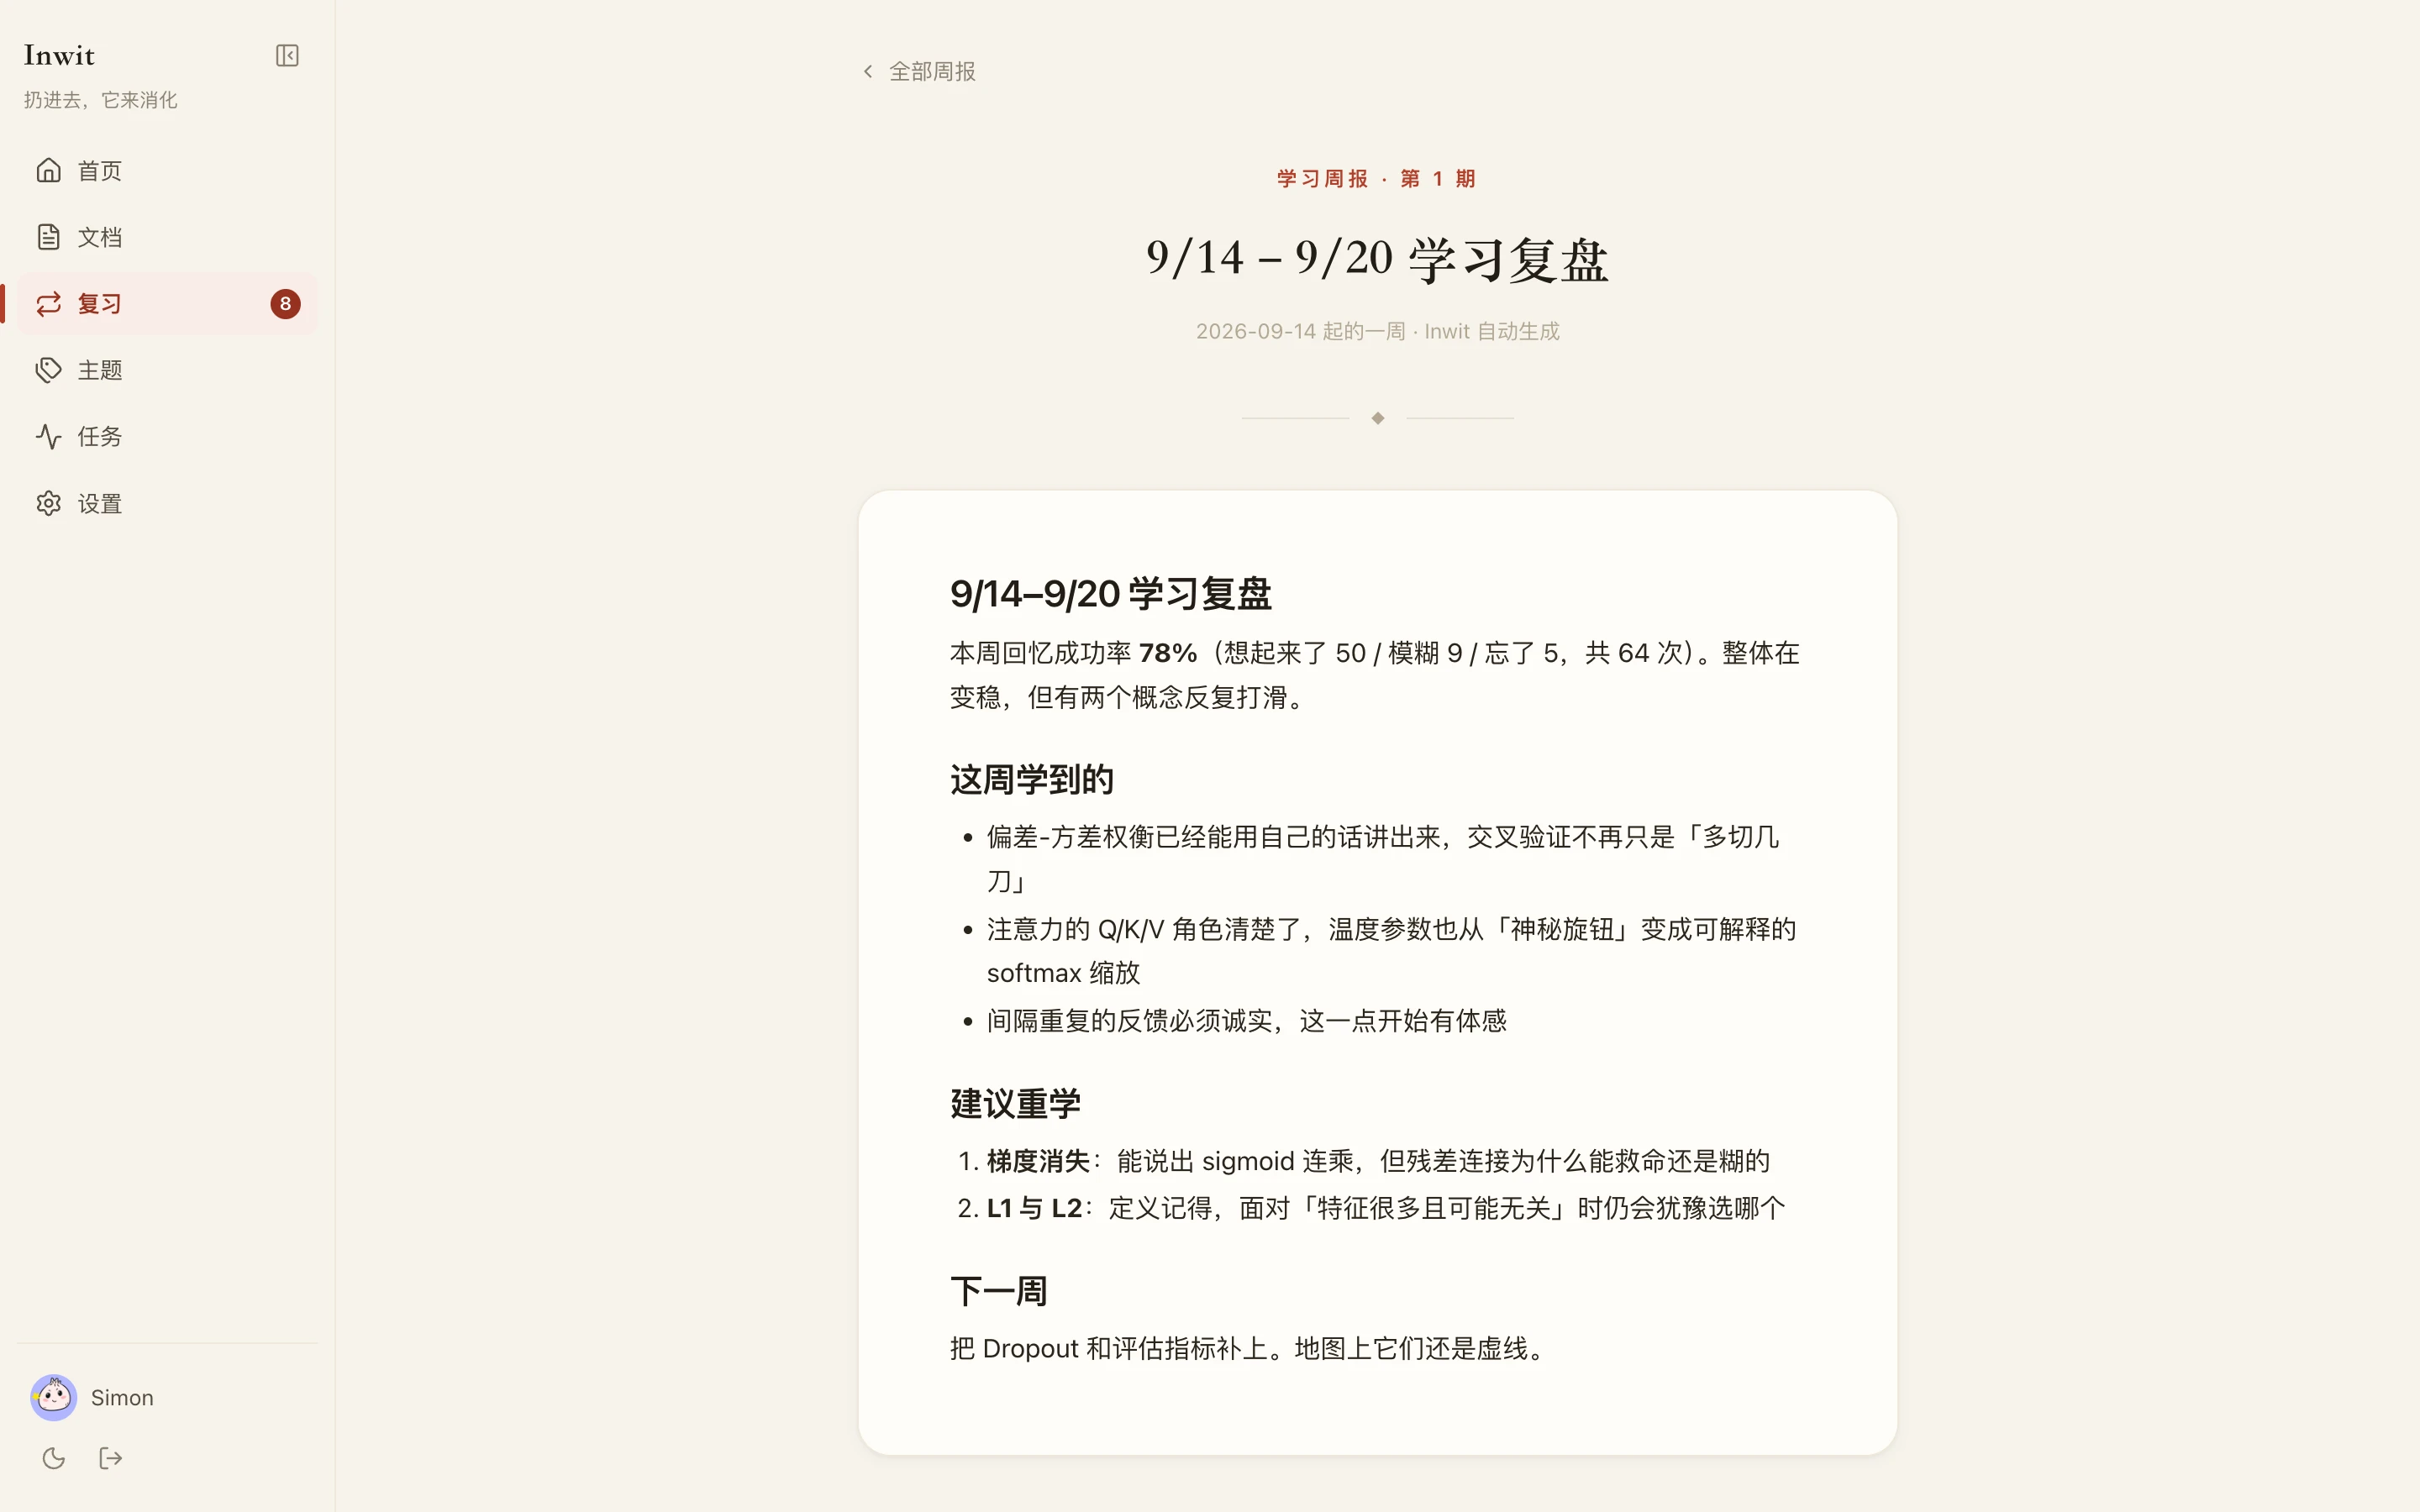
周报:每周自动写一份复盘,包括回忆成功率、反复打滑的概念、下一周该补哪块。
多端:Web(Vite / React)+ Desktop(Tauri 2)+ Mobile(Expo)三端共用同一套 Fastify API 与 zod DTO;pnpm workspace monorepo。
技术难点
AI First 的双向接口。 对内 worker 与对外 skill 走同一份 HTTP API 和同一份数据:外部 Agent 只负责投喂和读取,消化、SM-2、知识地图仍在服务端跑,不会产生「影子笔记」。
后台 Agent 的可恢复调度。 状态不在进程内存,全部落在 PostgreSQL:领取、超时回收、失败重试;没有 worker,文档会停在「消化中…」。消化、问答、主题、进化、周报、OCR 都是队列里的 job 类型。
三端一份 API。 Web 走 cookie auth,Desktop / Mobile 走 bearer token;zod DTO 前后端共享,改 API 先改 packages/dto。
检索。 中文语料下纯关键词和纯向量各有盲区;Qdrant 语义 + Meilisearch 关键词,RRF 融合后再 rerank。所有查询按 userId 隔离。